AI普及 · 2026/09/21
怎么让 ChatGPT / Perplexity 引用你的网站
想让 ChatGPT 和 Perplexity 引用你的网站,先放行搜索爬虫,再提供可直接抽取的文本。OpenAI 的 OAI-SearchBot 负责搜索露出,与训练爬虫 GPTBot 彼此独立;Perplexity 依赖 PerplexityBot 抓取和 Perplexity-User 实时取页。两家更新 robots.txt 约需 24 小时生效。配合 H1 下的短答块,挑 10 到 20 个提问复测引用即可落地。
想让 ChatGPT 或 Perplexity 在生成答案时引用你的网站,先看爬虫权限,再看页面文本。OpenAI 官方把用于 ChatGPT 搜索引用的 OAI-SearchBot 与用于模型训练的 GPTBot 分开;Perplexity 依靠 PerplexityBot 生成链接,用户提问时用 Perplexity-User 实时取页。robots.txt 改动后各需约 24 小时生效。页面主体文本能被爬虫完整读取,并在 H1 下方提供 40 到 60 字直接回答,模型才有内容可抽。
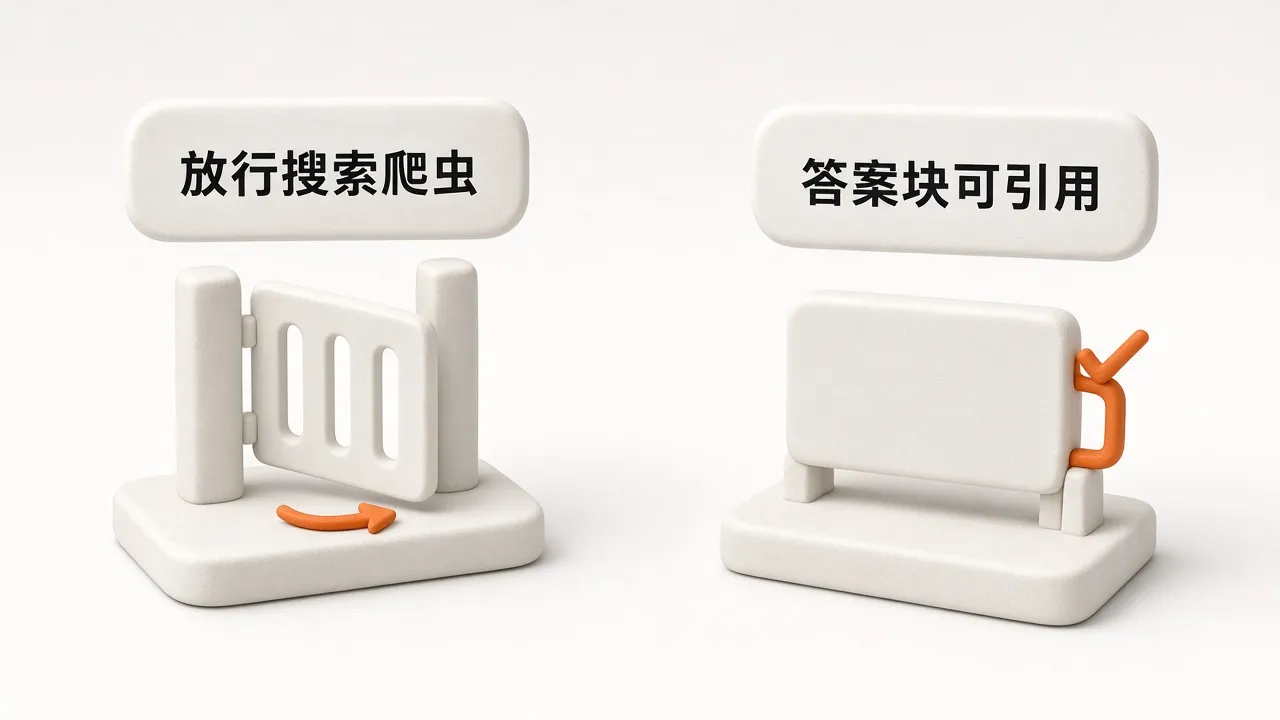
放行两家搜索爬虫
很多站点为了防内容被抓去训练,在 robots.txt 里面写了 User-agent: GPTBot 加 Disallow: /。
根据 OpenAI Developers 官方文档,GPTBot 专门抓取公开网页用于训练基础模型。负责在 ChatGPT 搜索结果与答案中引用网页的爬虫叫 OAI-SearchBot。两套爬虫彼此独立。封禁 GPTBot,并不会取消网站被 ChatGPT 搜索引用的资格。如果在 robots.txt 中封禁了 OAI-SearchBot,网页将不会作为来源出现在 ChatGPT 的搜索回答中,只可能作为普通导航链接出现。OpenAI 提供了 searchbot.json 公布爬虫 IP 列表,改动 robots.txt 约需 24 小时生效。
Perplexity Docs 同样说明了爬虫分工。PerplexityBot 用于建索引、在回答中展示结果与链接,不用于训练基础模型;Perplexity-User 则在用户直接发起提问时实时抓取网页内容。两家爬虫更新规则后均需约 24 小时生效。如果网站接入了 CDN 或 WAF,防火墙可能误拦截爬虫,需要根据官方发布的 IP json 文件加白。
Google Search Central 针对 AI Overviews 等功能给出的规范则不同:Google 没有单独的 AI 爬虫或专用 schema,只要常规 Googlebot 正常抓取索引,文本符合标准 SEO 规范即可。ChatGPT 和 Perplexity 还要在服务器与防火墙层单独放行各自的搜索爬虫。站点根目录补充 llms.txt 的配置,留给后续专篇。
页面提供可直接抽取的文本
爬虫放行后,模型能否引用取决于页面的文字结构。
- 重要结论写成纯文本。不要把参数、价格或核心步骤做成纯图片。爬虫抓取不到图片内的细节,也无法把图片作为文字证据插入回答。
- 去掉无条件的登录墙与验证码。如果页面强制跳转登录页,或者对自动化抓取弹出 CAPTCHA,OAI-SearchBot 与 Perplexity-User 只能读到拦截页,无法获取正文。
- 小标题下方先给简短结论。按照先前在 AEO 是什么?和搜索排名还差在哪一步 讨论的答案块规范,H1 或 H2 下方直接写 40 到 60 字的事实陈述,随后标明发布日期、出处或测试环境。一页集中回答一个明确问题。
如果团队使用自动化脚本发布内容,规范要求小标题下必带短答,见 AI 原生时代的软件工程:从「写代码」到「约束代码」。日常整理事实素材如果散落多处,先建立统一的数据沉淀流程,见 企业为什么不能只买 AI 账号?。
怎么用:一周三步排查
站长排查被引用的门槛,一周内分三步处理:
第一步:检查 robots.txt 与 WAF 规则
打开根目录 robots.txt,确认明确允许 OAI-SearchBot、PerplexityBot 与 Perplexity-User。如果需要保护原创数据不参与模型训练,单行配置 User-agent: GPTBot 加 Disallow: / 即可。检查 CDN 或防火墙拦截日志,确保没有阻断两家爬虫的公开 IP。
第二步:改造 3 到 5 个核心页面的正文 挑选 3 到 5 个有明确解答场景的产品或技术说明页。检查 H1 下方是否存在直接回答。将核心参数以表格列出,步骤用编号标明,补齐更新日期。确保未登录状态下直接通过浏览器隐身模式或 curl 可以看到完整 HTML 文本。
第三步:用 10 到 20 个提问做基线测试 改动配置后等待 24 小时以上。整理 10 到 20 个客户的真实提问,分别输入开启搜索功能的 ChatGPT 和 Perplexity。记录系统回复中是否出现你的网页链接,计算当前被问中的引用率。等待两周后,用完全相同的问法再次测试记录,对比引用情况的变化。
ChatGPT 引用网站:常见问题
怎么让 ChatGPT 引用我的网站?
先在 robots.txt 中放行 OAI-SearchBot,并在 WAF 中放行其官方公布的 IP。其次确保页面无需登录即可抓取完整文本。最后在文章 H1 标题下方直接给出 40 到 60 字的直接结论并附带更新日期,让系统能够抽取完整事实。
拦了 GPTBot,ChatGPT 还会引用吗?
会。根据 OpenAI 官方文档,GPTBot 仅用于抓取网页训练模型,OAI-SearchBot 才是用于 ChatGPT 搜索引用的爬虫。拦截 GPTBot 不影响网站进入 ChatGPT 搜索来源,只有屏蔽 OAI-SearchBot 才会退出 ChatGPT 的搜索回答。
引用率怎么测?
整理 10 到 20 个与业务相关的客户提问,输入开启搜索的 ChatGPT 与 Perplexity。统计生成回答中附带你网站链接的问题数量,除以总提问数,得出当前提问集下的基线引用率。改动 robots.txt 与答案文本两周后,用相同的问题集再次运行测试,对比引用率。