
AI编程
Mac mini 内存选多大:跑本地大模型
选购 Mac mini 内存规格用于运行本地大模型,直接决定设备能装下的模型参数上限。按参数规模倒推配置,十六 GB 适合一百四十亿参数以内,三十二 GB 适合三百亿参数,六十四 GB 承载七百亿参数。购买时结合内存带宽与多任务开销综合测算。
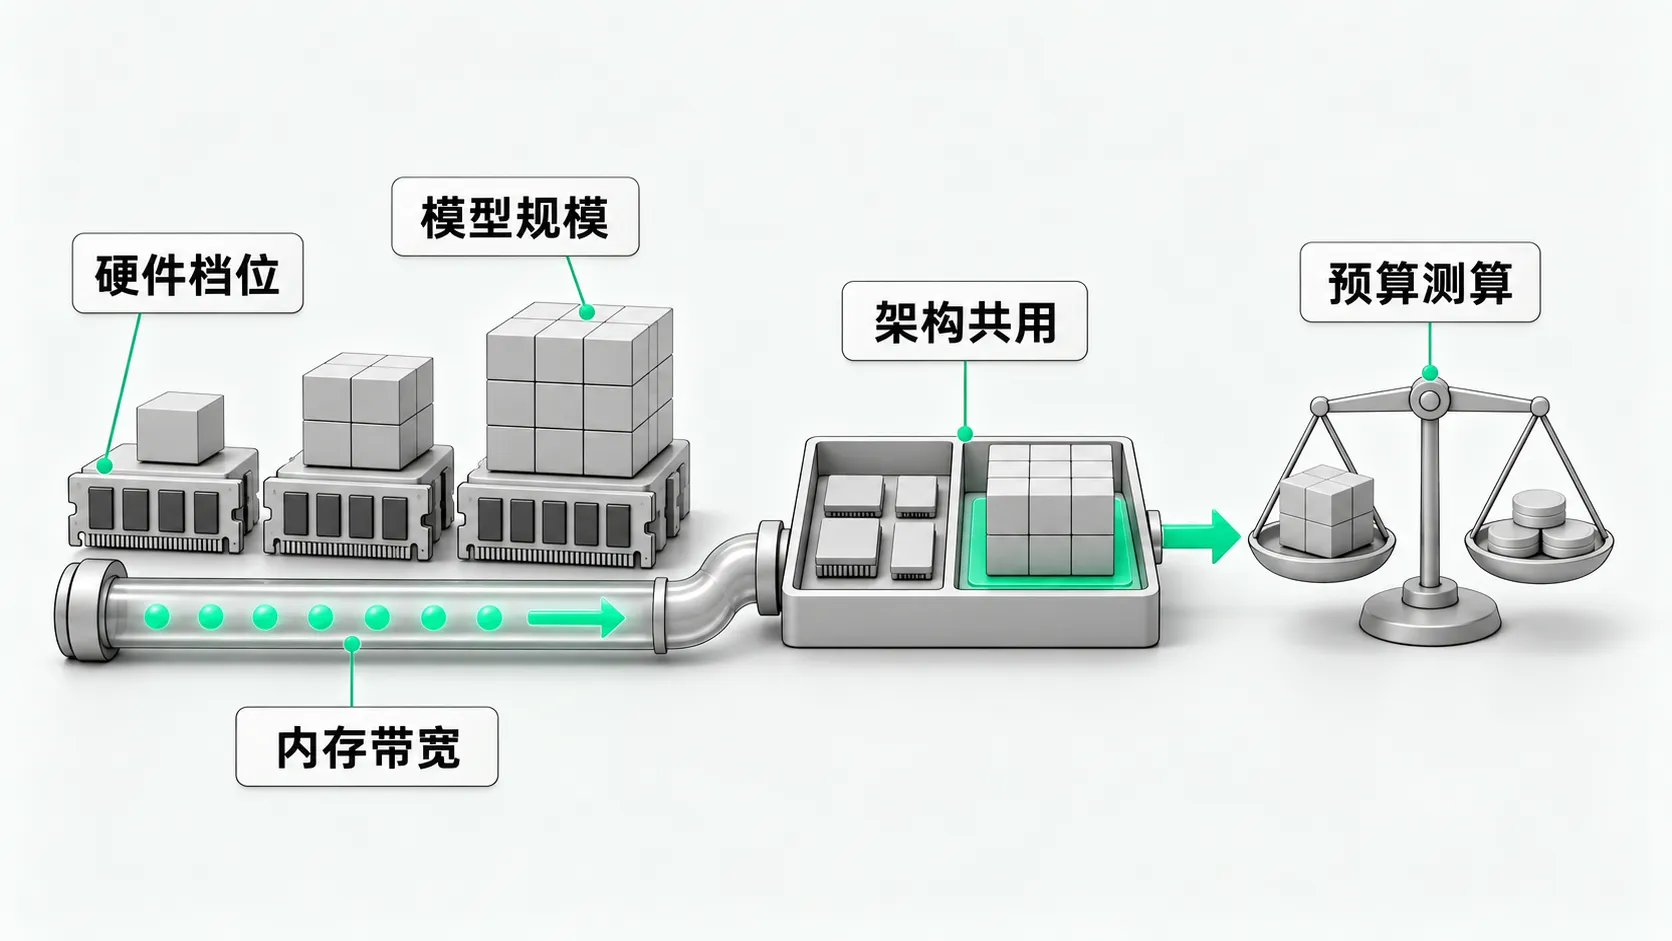
买 Mac mini 跑本地模型,先按想跑的模型规模定 Mac mini 内存档,再看带宽,最后把机器的一次性支出和按量调用的费用放在一起算。内存装不下就无法加载运行。统一内存由 CPU 和 GPU 共用,操作系统和其他日常软件也要分走一部分空间,选型前先把模型参数量、内存带宽和并发人数算清楚。
先看现在能买到哪几档
根据 Apple 官网 Mac mini 规格页,M6 机型标配十六 GB 统一内存,可选二十四 GB 或三十二 GB;另一款 M6 机型标配二十四 GB,可选三十二 GB;M5 Pro 机型标配二十四 GB,可选四十八 GB 或六十四 GB。Apple 规格页把内存列在购买时的配置选项里。
Mac mini 的统一内存是 CPU 和 GPU 共用的,操作系统、日常打开的开发工具、浏览器标签页都会占用同一块内存池。如果配置规划过窄,留给模型权重的空间就会受到挤压。在确定购买前,先统计日常软件占用的内存量,再预留出充足的硬件余量。
按模型规模倒推内存
根据 mlx.app 运行指南 二〇二六年十月十九日更新的内容,内存决定能装下哪些模型,四位量化下每十亿参数约需零点五五到零点六 GB,还要给上下文和系统留余量。四位量化下的舒适规模为:十六 GB 约一百四十亿参数以内,三十二 GB 约三百亿参数以内,六十四 GB 约七百亿参数以内。
七百亿参数模型在四位量化下的权重约为四十 GB,设备需要六十四 GB 或以上内存才能稳定承载。这些数值是近似值,实际运行中的量化方式、上下文窗口长度以及同时打开的其它应用都会影响内存开销。比如计划在 Mac 上部署高规格开源模型,可以对照 Qwen3.8 显存要求:27B 用哪个量化档 中各量化档的内存门槛,确认三十二 GB 档位是否满足目标模型的运行门槛。按内存档挑具体量化文件、在 Mac 上把模型跑起来,见 在 Mac 上用 Unsloth 本地跑 Qwen3.8-27B。
内存装得下之后再看带宽
根据 mlx.app 运行指南,内存带宽决定运行速度。模型在推理过程中需要持续从统一内存读取权重,带宽的高低直接影响输出流速。
不同芯片机型之间的内存带宽存在明确差异。根据 Apple 官网 Mac mini 规格页,M6 十六 GB 机型的内存带宽为每秒一百五十三 GB,M6 二十四 GB 和三十二 GB 机型为每秒一百七十 GB,而搭载 M5 Pro 芯片的机型内存带宽达到每秒三百零七 GB。虽然三十二 GB 内存的 M6 机型能装下三百亿参数模型,但在高频对话或者长文本处理时,带宽更高的 M5 Pro 机型能提供更顺畅的响应体验。
买之前把用途和预算算清
规划采购预算时,要把本地硬件支出与云端调用成本统一核算。本地设备属于一次性固定硬件投入,后续没有按次推理费用;云端模型服务按用量计费,开箱即用但持续调用会产生费用。在企业财务管理与技术选型中平衡这两种开销模式,可以参考 AI 按量计费后,企业一年一编的预算还管得住吗? 中的预算拆解框架,把机器折旧周期与团队调用量结合起来算清总账。
根据 Apple 官网 Mac mini 规格页,M6 机型最高可选三十二 GB,只有 M5 Pro 机型可选四十八 GB 或六十四 GB。根据 Ollama 官方博客 二〇二六年三月三十日发布的信息,Ollama 的 MLX 预览版官方要求统一内存超过三十二 GB,所以打算用这个预览版,只能看 M5 Pro 的四十八 GB 或六十四 GB 配置。多人共用时,每个人的上下文都会占内存,按同时在用的人数留余量。
Mac mini 内存:常见问题
日常写代码兼跑模型选哪一档合适?
按照 mlx.app 教程给出的近似表,四位量化下十六 GB 统一内存约能承载一百四十亿参数以内模型,三十二 GB 约能承载三百亿参数以内模型。开发工具和浏览器与模型共用同一块统一内存,选型时要按模型权重加上日常软件的内存开销一起估算,给日常任务留足空间。
为什么相同内存容量下推理表现会有区别?
推理运行速度受内存带宽直接影响。根据 Apple 官网 Mac mini 规格页,M6 十六 GB 为每秒一百五十三 GB,M6 二十四 GB 和三十二 GB 为每秒一百七十 GB,M5 Pro 为每秒三百零七 GB。同样是二十四 GB 内存,M6 机型是每秒一百七十 GB,M5 Pro 机型是每秒三百零七 GB,生成速度也会跟着不同。
十六 GB 的 Mac mini 能跑本地大模型吗?
十六 GB 的 Mac mini 能跑本地大模型,但在四位量化下通常只能承载一百四十亿参数以内的本地大模型。系统本身和其他日常软件也会占用内存,运行本地大模型时可用空间相对有限,采购前先对照目标模型的参数量确定配置。