
Loop与方法论
多 Agent 编排:主 Agent 空等 73%,趁早拆掉
多 Agent 编排里,主 Agent 干等 subagent 交接摘要:Terminal-Bench 4.0 一个任务上空等 73%。本文对照 Anthropic 的单循环和 Stanford DeLM 的共享日志加任务队列,写清怎么选、怎么改和五处易错点。
多 Agent 编排常见的做法是把任务拆给一堆 subagent,再让主 Agent 传话。Terminal-Bench 4.0 的 retro-console-soc 任务上,四个 Claude Opus 5.5 跑 Claude Code 原生 subagent,主 Agent 有 73% 的时间都在空等,四个 Agent 合起来也有 44% 的时间在等。
Anthropic 在 2026 年 10 月 22 日发文劝开发者把非必要 subagent 折回单循环,单个客户从多 Agent harness 切到单循环快了大约 2 倍,这组企业对比未公开数据集。10 月 4 日修订的 DeLM 论文中,Stanford 的 Azalia Mirhoseini 团队直接移除了主 Agent;同一个 retro-console-soc 四 Agent 任务上等待时间占比降到 2%,完成时间快 5.5 倍。
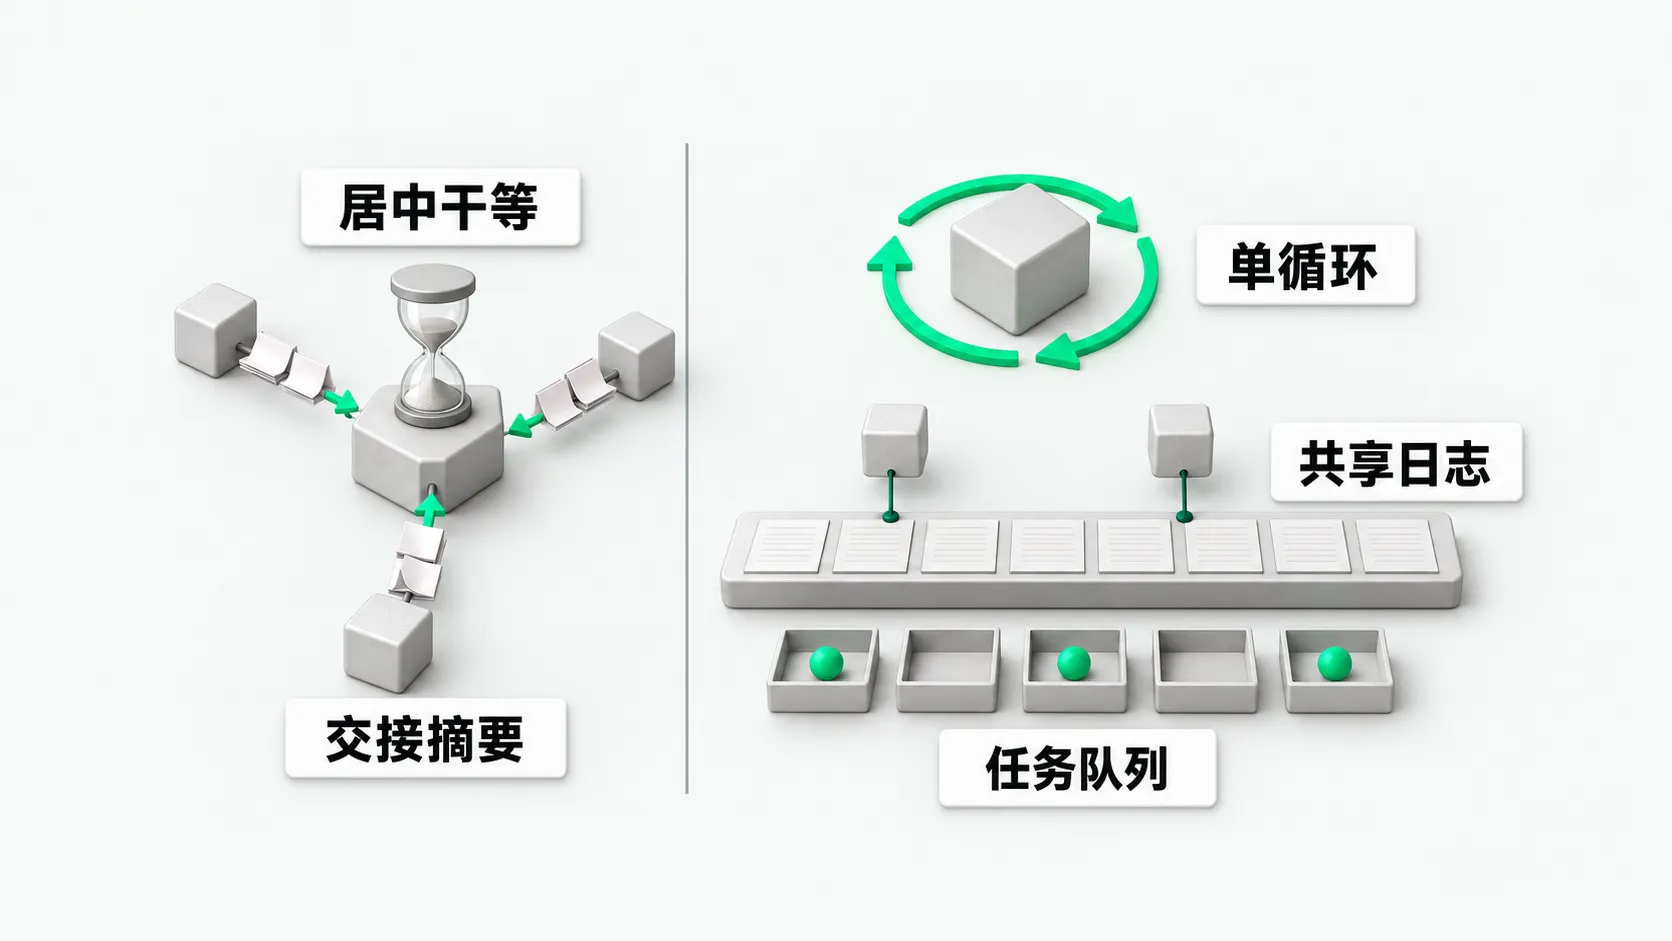
我们的判断:两边要拆的都是主 Agent 干等 subagent 返回交接摘要。两份材料没在同一组任务上直接对比,没法互相否定;两份材料各自给出了交接摘要经主 Agent 在中间转述后变差的数据。选型:跟用户对话的单一业务流程合并回单循环;长任务如果能拆开并行、慢在等待和重复干活上,换用共享日志配任务队列。
单循环怎么搭:Anthropic 路线
单循环只留一个模型、一个上下文窗口和开放工具循环,不再按部门或问题类型复制组织架构建 subagent。每轮模型发出一批工具调用,harness 并行执行后把原始结果交回同一个模型,计划在上下文里随结果改。顺序和领域流程放进 skills;Claude Code 给更强模型的系统提示词削减 80% 以上,部分来自 skills 和工具的渐进披露。一条回路怎么自查、何时停,见 什么是 Loop Engineering:让 AI 先自查再交付。
迁移 kit anthropics/single-agent-loop-kit 是不维护的参考实现,reference_loop/loop.py 里的默认值:max_turns = 25;max_tokens = 400_000 按单次运行汇总输入输出并计入 subagent 消耗;max_batch = 16 限制单轮最多 16 个调用,多出的返回错误。读操作最多 8 线程并行,带 writes=True 的写操作排在读后串行过写门;可选 verifier,被拒两次的答案不返回。
共享日志加任务队列怎么搭:DeLM 路线
DeLM 仓库 github.com/yuzhenmao/DeLM 去掉了特权规划者,换成只追加的共享日志加任务队列,支持 Claude Code 和 Codex,跑 n=2 或 n=4。共享日志记录带观测的 fact、被否定的 fail 和子任务结果 completion summary,fact 与 fail 带范围和证据字段,Agent 每次只读上次之后的新内容。附带文件发布时做快照按引用存,同伴用 expand 看 diff、用 apply 拷入本地,遇上解释不了的本地改动就拒绝覆盖。
任务队列写明预期输出与可用输入,标清接口和最早依赖结果,首个 claim 生效,每个 Agent 最多拿一个未完成 claim;交完整方案独立打分前,得先处理相关的未关闭 fail。
DeLM 的数字要带条件看
DeLM 的数字有前提:每组只有 10 个长任务,数据为三次运行均值。
跑完时共享日志平均不到 15K token,读取成本在 Claude Opus 5.5 占 1.7% 到 3.7%,在 GPT-6-Astra 占 7.7% 到 17.7%。Hugging Face 公开的 720 条轨迹里文件导入 5,237 次,80.3% 的轨迹后来又导入修订版。
Terminal-Bench 4.0 这 10 个长任务上:
- Claude Opus 5.5 单跑 Claude Code 准确率 81.67%,耗时 130.75 分钟,单任务 $20.31;
- 开原生 subagent 掉到 80.00%,138.58 分钟,$30.88;
- DeLM
n=2两个 Agent 升到 93.33%,64.77 分钟,$17.91。
Anthropic 留出的主要是三种情况:单循环上下文变长测出退化,并行任务要用完即弃的全新上下文,或单 Agent 选错工具、系统提示词指令冲突。
动手改时容易出错的五处
后台空闲上限 600 秒
DeepSWE v1.1 的 10 个长任务、三次运行均值里,Claude Code 开原生 subagent 准确率从 71.67% 跌到 50.00%,延迟涨 15.9%,成本涨 65.1%,失败多是空补丁和超时。常是因为主 Agent 负责最终提交却在干等。论文脚注写明,Claude Code 对后台 subagent 连续空闲等待默认上限 600 秒,到点直接终止未完成的 subagent 并退出进程。
折叠后的偶发回归
把 subagent 折进单循环也会出偶发回归。Anthropic 示例客服 Agent 合并后延迟降了,一条原本通过的流程出现回归:主 Agent 有订单查询工具,就自己答了物流问题,没调物流 subagent 拿送达日期。该故障在两次运行中仅出现一次,如果只测一遍、不读已通过邻居任务的 trace 就容易漏掉。
硬限制挪进工具会假通过
skill/steps/03-fold.md 写道:“Prove a moved rule with a direct call”,意思是规则挪进工具后,要直接调用一次工具,验证拒绝是否生效。端到端 eval 里模型如果没试禁止动作,通过证明不了工具会拒绝。
30 到 50 个工具定义上限
单循环受工具数限制:如果一个 API 配一个工具,系统提示词里工具定义超过 30 到 50 个后选工具会变差。
DeLM n=4 降准确率涨成本
DeLM 加并发 Agent,在这组测试里准确率下降、成本上涨。Terminal-Bench 4.0 这 10 个长任务、三次运行均值下,Claude Opus 5.5 跑 DeLM n=4 四个 Agent 耗时 52.51 分钟、快 2.49 倍,准确率却从 n=2 的 93.33% 掉到 89.17%,成本涨到 $29.98;GPT-6-Astra 单跑 Codex 是 71.67%、$9.01,跑 DeLM n=2 两个 Agent 升到 85.00%,标准差 ±13.23,每次提交 $6.83,单任务却要 $13.65。每个 Agent 仍要交完整方案,所以 n=4 比 n=2 快,准确率却低 3 到 4 个点。
单循环和共享日志怎么选
主 Agent 只负责分发子任务、干等返回、再重述一遍交接摘要时,即使这套结构贴合团队分工、方便查归属,只要实测等待时间占比偏高,就该拆掉:合并成单循环,或改成共享日志。多条回路之间谁先做、谁等谁,见 Graph Engineering 不是替代 Loop,是上面一层。
在单循环和共享日志之间:
- 要跟用户对话的常规企业业务流程优先选单循环,代价是业务增多后得用
tool search管住 30 到 50 个工具定义的上限,遇到长并行任务时单循环也会偏慢。 - 如果长任务能拆开并行、慢在等待和重复干活上,换用共享日志配任务队列。
按 measure、combine、fold 顺序改
改动时按 measure、combine 和 fold 顺序做,写进脚本、单元测试和配置里:
- 拿 10 个 golden example 起步建端到端 eval 配合各
skill小集合,每条任务跑多次,测清等待时间占比、工具定义数和路由准确率;合并前跑skill/scripts/chain_coverage.py,如果 Agent 链路缺任务、返回退出码1就停。 - 按
skill/steps/03-fold.md每次折一个 subagent,把 subagent 提示词拆五处:流程进skill正文,资料进参考文件或查询工具,人设语气与think step by step删掉,前置条件和用户权限写进工具返回可读拒绝,每条硬限制直调工具写单元测试;按意图分组工具配tool search延迟加载,改完读邻居任务的 trace。 - 在 harness 按
reference_loop/loop.py管住轮数、含 subagent 的总 token 和单轮调用上限,读操作并行,writes=True工具过写门,allow_all_writes只在没人可问的 eval 里开。 - 长并行任务别让主 Agent 阻塞干等。想试 DeLM,先用仓库里的
python3.13 -B delm.py retro-console-soc --n 2 --harness claude-code在公开任务上复现,再装delm-agent-plugin在 Claude Code 或 Codex 里从两个 Agent 起步;自己搭的话,共享日志记下fact与fail,文件按引用传。
今天就能做的两项检查:打开多 Agent 运行日志,先算出主 Agent 的等待时间占比,再跑一遍 skill/scripts/chain_coverage.py 看退出码是否为 1。
多 Agent 编排:常见问题
主 Agent 等待时间占比怎么算出来、多高该拆?
打开多 Agent 运行日志,算出主 Agent 的等待时间占比。Terminal-Bench 4.0 的 retro-console-soc 任务上,四个 Claude Opus 5.5 跑 Claude Code 原生 subagent,主 Agent 有 73% 的时间在空等,四个 Agent 合起来也有 44% 的时间在等;DeLM 拿掉主 Agent 后,同一个四 Agent 任务的等待时间占比降到 2%。主 Agent 只负责分发子任务、干等返回、重述交接摘要,实测等待时间占比又偏高,这套结构就该拆。
把 subagent 折进单循环后,怎么防偶发回归?
端到端 eval 里每条任务跑多次:Anthropic 示例里那次回归在两次运行中只出现一次,只测一遍容易漏掉。每折完一个 subagent,读已通过邻居任务的 trace。挪进工具的硬限制,每条直调一次工具写单元测试,确认拒绝生效。
长并行任务什么时候改用共享日志?
长任务能拆开并行、慢在等待和重复干活上时,改用共享日志配任务队列。Terminal-Bench 4.0 这 10 个长任务、三次运行均值下,Claude Opus 5.5 单跑 Claude Code 是 81.67%、130.75 分钟、单任务 $20.31;跑 DeLM n=2 两个 Agent 是 93.33%、64.77 分钟、$17.91。加到 n=4 四个 Agent 更快,准确率却掉到 89.17%,成本涨到 $29.98,所以从两个 Agent 起步。