
安全可信
Agent 模型升级后,流程结果变了怎么办?
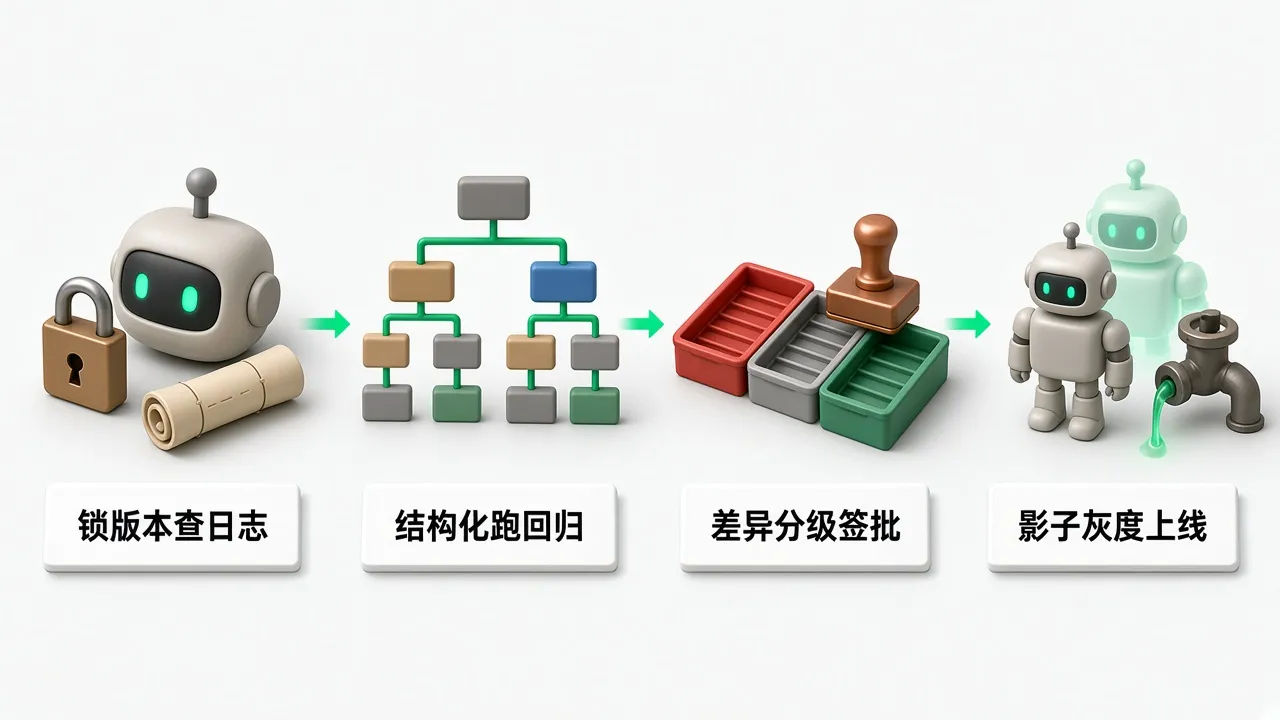
企业在进行 Agent 模型升级或排查线上流程行为变化时,先核对运行日志中锁定的模型、提示词与工具定义版本,再用锁定用例集跑回归测试比对工具调用结构,由业务流程负责人与质量风控团队共同签批分批上线。
Agent 模型升级后要是线上流程跑出来的结果变了,先查运行日志,核对实际服务的模型版本、提示词版本和工具定义版本;再用锁定用例集跑回归测试,把新旧版本的工具调用结构和输出结果逐条比对。红线用例被破直接拦下不上线;调用结构变了交给业务流程负责人逐条判断能不能接受;切流上线由业务负责人会同质量或风控签字拍板,工程团队不单方面做主。
先确认是不是模型变了
Agent 的行为由模型版本、提示词版本、工具定义版本三样东西一起决定,发布其中任何一样都等于一次上线。调接口时只写模型家族的浮动别名、不写具体日期版本,提供商可能在别名背后换成行为不同的新版本;仓库里一行代码没改,上周通过的评测针对的已经是另一个模型。
日常调用可以配置成固定到带日期的具体版本,在每次运行日志里记下实际服务的模型版本、提示词版本和工具定义版本;有的接口在响应里返回实际服务的模型名,可以配置成回读核对。提示词、模型、工具定义或检索设置任何一项变了,都要重跑全套回归测试。检索分块方式变了、工具返回多了字段、对话历史变长,也会把 Agent 原先依赖的内容挤出视野;线上常不报错,回答照样流利,判断依据已经变了。
回归测试比什么
做 Agent 模型升级时,回归测试用一套锁定的用例集:有代表性的常见请求、几个边界用例、至少一个测「永远不许破的规则」的红线用例(比如超出授权额度转人工)。用例集别随手改,改了就没法跟以前比。换模型时只动模型这一个变量,提示词、工具定义、工具返回的测试数据、用例集、评判方式和推理参数全部固定;不同模型接受的参数不一样,一侧设了的参数另一侧可能忽略,跑前先核对。升级前后重点比三块:
- 工具调用与参数:核对有没有调对工具,传进去的参数值和格式准不准。
- 政策遵守与追问:核对有没有遵守业务规则、缺信息时知不知道先追问;要是只比对最终回复文字,会把措辞不同但办对了事的结果误判成失败。
- 用例与评判器自检:新旧两边都失败的用例,先查测试本身是不是写坏了;评判打分如果对什么答案都给满分,就等于没测,拿一个已知是错的答案喂进去看分数会不会动。同一用例还要多跑几次来排除随机噪音,做法见 Agent 评测怎么做:每个任务跑几次才算数。
差异怎么分级、谁拍板
跑完锁定用例集后,不能只看整体通过率,单条用例分数下滑也算回归。工程团队把新旧版本跑出来的所有差异拉成清单,按风险分成三类,交给对应的负责人逐条核定:
- 硬性红线被破:硬性红线没有容忍阈值,只要破一次就马上转入人工审查,修好之前一律不准上线。
- 调用结构变化:调工具的顺序、传参组织方式或缺信息时的追问行为变了,交给业务流程负责人逐条判断业务上能不能接受。
- 风格与措辞变化:工具调用链和业务结论一致、只是文字表述风格变了,作为普通判断题交给业务方确认。
清单上的差异全部核对完后,新版本能不能切流上线,由业务负责人和质量或风控一起签字确认;工程团队只提供评测对比报告,不自己拍板切换。
新版本怎么分批上线
拿到业务与风控的签批后,新版本不能一把全量替换旧版本。生产发布要分四个阶段往前推,同时把线上正在跑的在途流程隔离保护好:
- 影子运行:可以配置成让新旧版本并行跑线上真实流量,对外只输出旧版本结果,后台离线比对两边行为差异。
- 小流量灰度:先挑内部流程或低风险业务切小流量试跑;从试点扩到生产还要核对哪些准备项,见 Agent 试点能跑通,扩到生产还缺哪几项?。
- 看指标扩量与冻结:评测指标和线上护栏指标保持正常才逐步扩大流量,一旦出现回归就立刻冻结。
- 旧版保留可调与在途不换:上一版本继续保持可调用;已经在跑的流程一律按它启动时打上的版本号跑完,中途不换模型。
Agent 模型升级:常见问题
仓库里一行代码没改,为什么 Agent 的行为突然变了?
常见原因是调接口时用了不带日期的浮动别名,提供商在别名背后换了新版本;也可能是检索分块方式变了、工具返回多了字段,或者对话历史变长,把 Agent 原来依赖的内容挤出了视野。排查时先翻运行日志,核对实际服务的模型版本、提示词版本和工具定义版本。
升级切换时,正在跑的流程会中途换上新模型吗?
不会。升级期间上一版本继续保持可调用,已经在跑的在途流程一律按启动时打上的版本跑完,中途不换模型;切换后新发起的流程,才按灰度规则进入新版本。
厂商说新模型更强,回归测试还要跑全套吗?
照样要跑全套。新版本在外部公开基准上分数更好,放到你的具体任务上表现可能反而变差,厂商的发布说明替代不了企业自己的实测。每次升级都要拿锁定用例集把回归测试完整跑一遍,红线用例一个都不能破。